
视觉AI-OCR
适用于
 通用
分类(旧)
OCR AI关键词
lwater25
爱吃馍的小张
瞑空凌
thxing
等
4 人赞了这个动作
。
更多信息
| 分享时间 | 2026-08-19 09:04 |
| 最后更新 | 2026-08-29 14:23 |
| 修订版本 | 10 |
| 用户许可 | 可自己使用或修改,不可再分享 |
| Quicker版本 | 1.45.5 |
| 动作大小 | 176.5 KB |
| 最低Quicker版本 | 1.42.21 |
「调用用户自定义视觉模型进行OCR,并在WebView2窗口中编辑预览,并且与ai对话」
简介
视觉AI-OCR
截图识别图像中的文字、公式和表格,输出标准 Markdown
功能
- 区域截图 → 多模态视觉模型 OCR → 输出 Markdown(文字、LaTeX 公式、表格)
- 自动复制:识别结果可自动复制到剪贴板
- 内置工作台:查看识别结果、预览渲染效果,可继续对话修正结果
- 多供应商支持:OpenAI 兼容接口、Anthropic兼容接口
- 灵活模型配置:每个供应商支持多个模型,每个模型可独立配置扩展参数(如
reasoning_effort、thinking)
使用
- 右键点击动作图标 → 选择「设置」:添加供应商,填写 API Base / API Key,添加模型并激活。
- 运行动作:框选截图区域,即可自动识别。
- 点击「打开工作台」可继续对话以修正或优化结果。
参考模型(以下仅供参考,可自选适合需求的模型)
国内
qwen3.8-flash阿里百炼glm-4.6v-flash智谱doubao-seed-1.6-vision火山deepseek-v4-flash-vision-expDeepSeekkimi-k3月之暗面ernie-4.5-turbo-vl百度hunyuan-t1-vision腾讯
国际
gemini-3.5-flashGooglegpt-5.4-miniOpenAIclaude-sonnet-5Anthropicgrok-4-visionxAI
配置示例
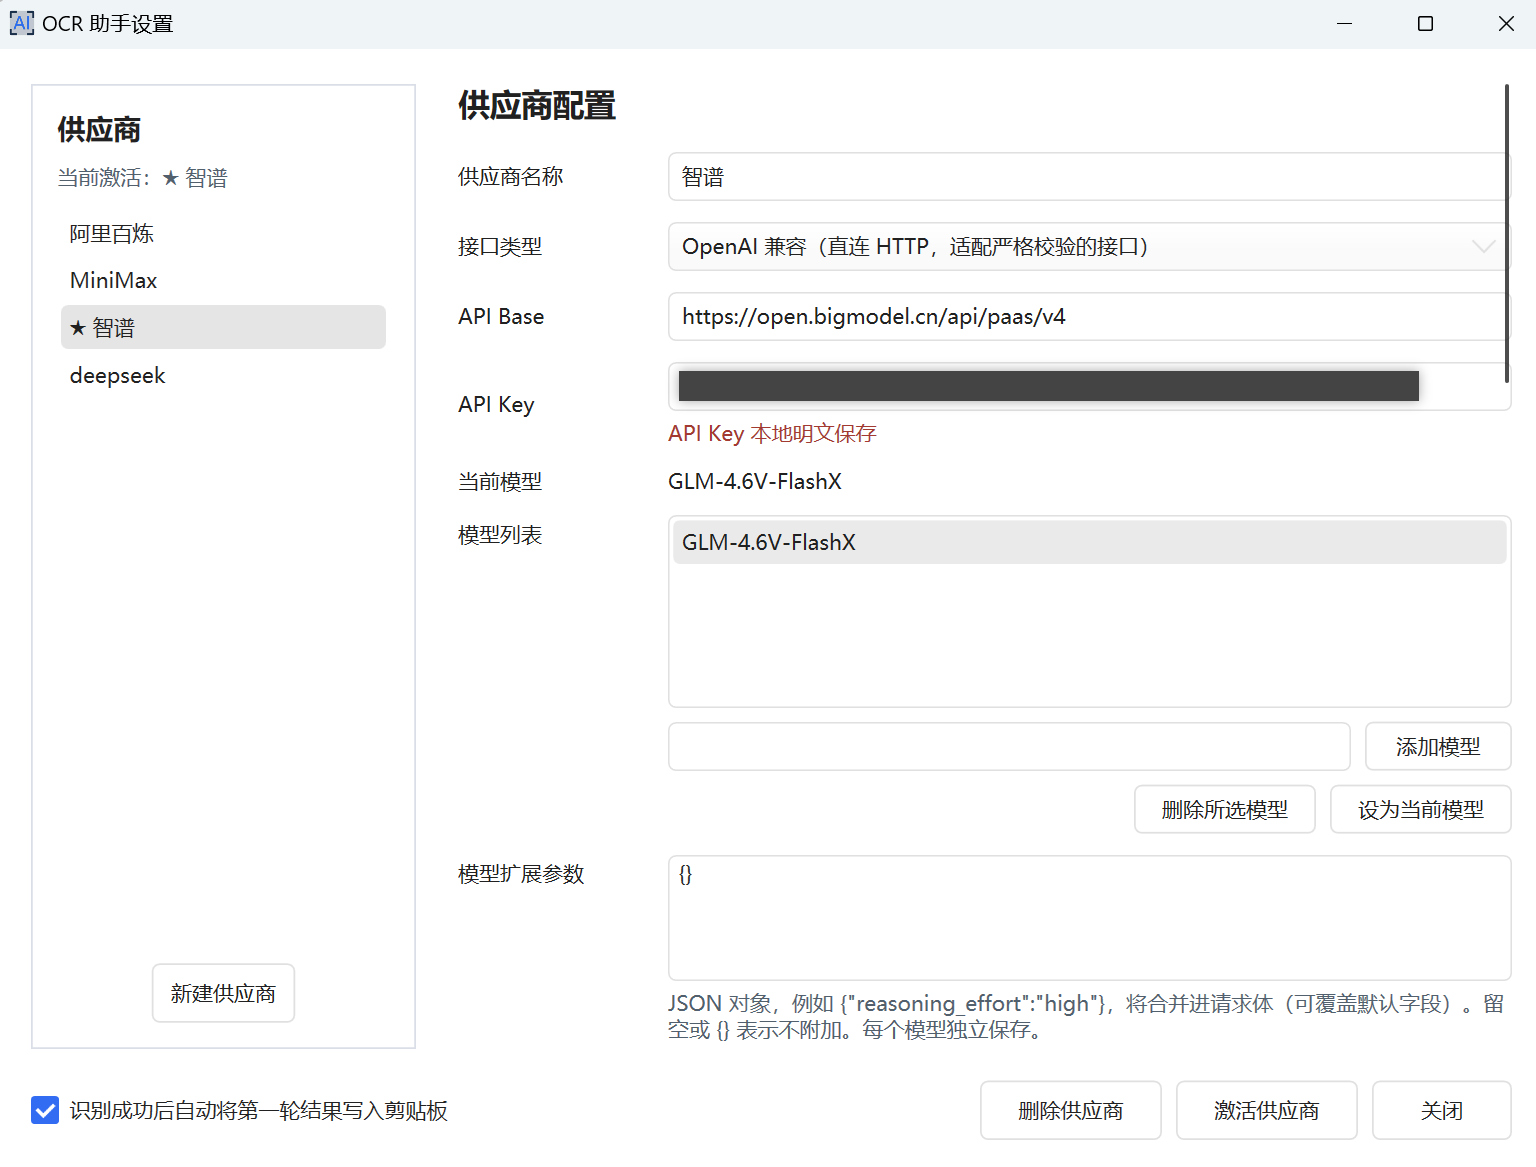
在 Quicker 动作设置中添加供应商与模型
识别效果
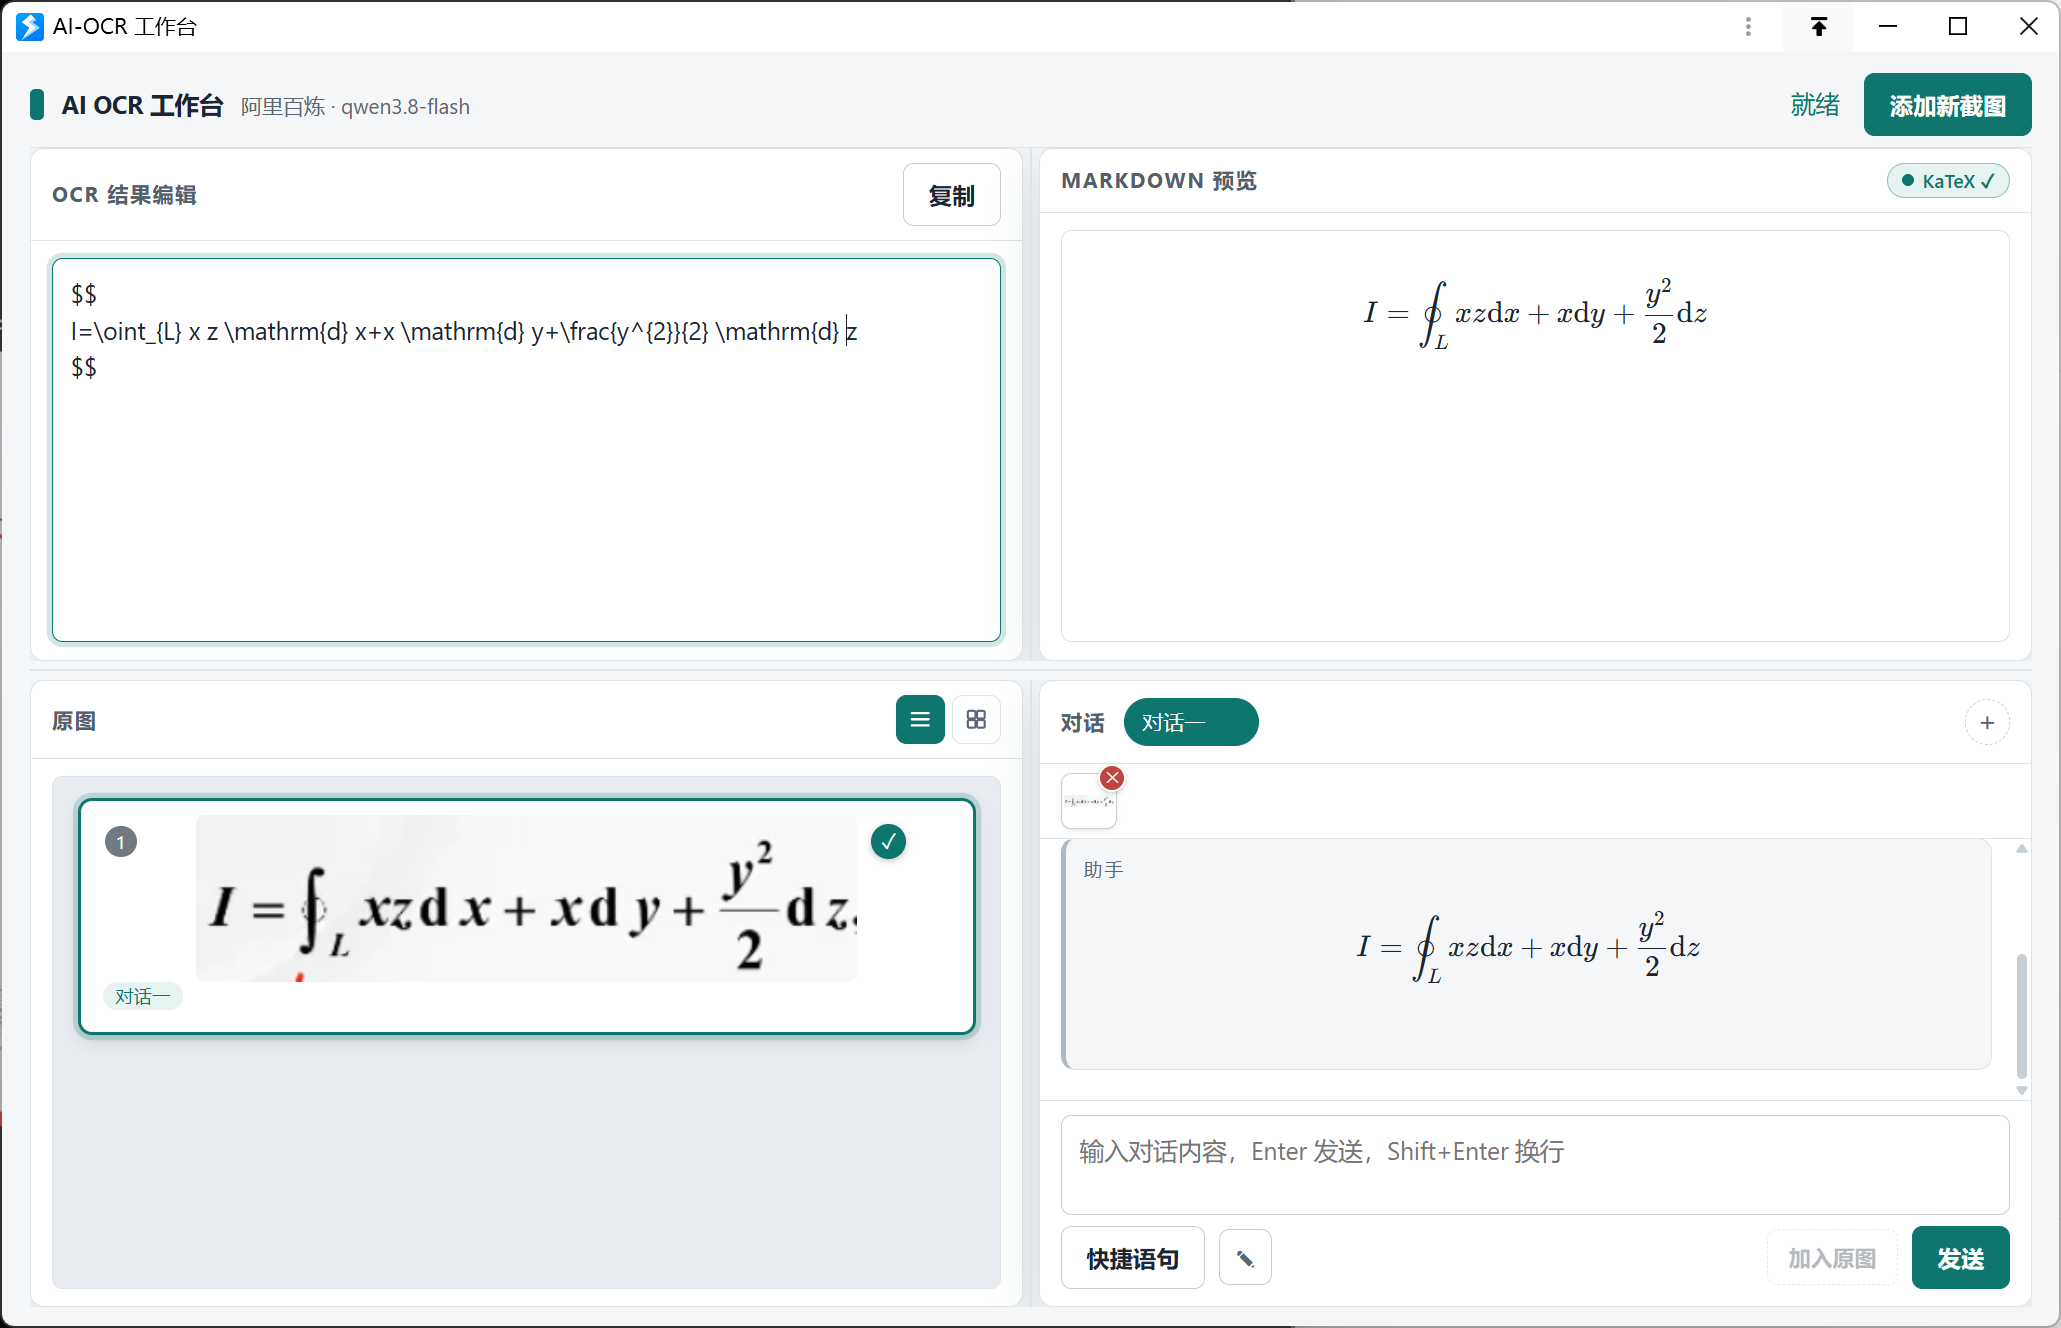
截图中公式、表格与文字被精准识别并渲染
🚀 高效 OCR · 多模型适配 · 智能工作台
作者所声明的动作特征:
- 会自动下载依赖组件
- 含有上传数据到网络的功能
最近更新
| 修订版本 | 更新时间 | 制品 | 审核状态 | 更新说明 |
|---|---|---|---|---|
| 10 | 2026-08-29 14:23 | V1 | 当前 V1 版本 |
KaTeX本地加载,更快的公式渲染。
可多图识别,使用更方便。 |
| 9 | 2026-08-26 15:20 | V1 | 更换klatex渲染引擎 | |
| 8 | 2026-08-26 11:51 | V1 | 开启html渲染 |
最近讨论
暂无讨论
 京公网安备 11010502053266号